626次
压测请求 · 0 失败
0.27s
流式首字节 TTFB
262tok/s
单请求生成速度
1666tok/s
32 并发总吞吐
100%
60s 持续压测成功率
真实压测,数据说话
测试时间 2026-11-05,Python 异步并发压测,端点 api.thhtcloud.com · 模型 glm-5.3-flashx。全部 5 项测试、626 次请求零失败。
并发扩展曲线(1 → 32 路逐级加压)
RPS 在并发 16→32 进入平台期(约 8 请求/秒),但吞吐仍线性爬升至 1666 tok/s,平均延迟仅从 0.80s 升至 1.36s,无排队雪崩。
关键延迟指标
| 指标 | 数值 | 说明 |
|---|---|---|
| 非流式平均延迟 | 0.76s | p95 0.79s |
| 流式 TTFB | 0.27s | 最快 0.22s |
| 长输出生成速度 | 213.7 tok/s | 512 tokens / 2.4s |
| 60s 持续压测 | 542/542 | 成功率 100% |
| 最大延迟(32 并发) | 1.44s | 无 5xx 无限流 |
延迟分布极差仅 0.16s,无长尾抖动;持续压测下延迟无漂移(0.78s vs 0.76s),服务端无热积累。
为什么选 GLM-5.3-FlashX
GLM-5 系列首个原生多模态模型,以极致低成本架构实现超越上一代旗舰的智能。
原生多模态
图片、视频、文件原生理解,视觉能力融入 Coding 与文档工作流,无需外挂 OCR。
1M 超长上下文
1024K 上下文窗口,最大输出 128K,长合同、长研报、整库代码一次喂入。
200+ tok/s 高吞吐
FlashX 加速版推理速度 200 tokens/s 起,生产实测 262 tok/s,长输出稳定 213.7 tok/s。
OpenAI 兼容协议
Chat Completions 接口开箱即用,SDK 零改造接入,支持流式 SSE 与 Function Calling。
上下文缓存
重复系统提示词与历史对话自动缓存命中,长对话场景成本与延迟双降。
生产级稳定性
60 秒持续压测 542 请求零错误、无限流、无 5xx,延迟无漂移,可放心投产。
两行代码接入
把 Base URL 指向天鸿智算端点,用你现有的 OpenAI SDK 即可调用。
curl https://api.thhtcloud.com/v1/chat/completions \
-H "Content-Type: application/json" \
-H "Authorization: Bearer sk-****" \
-d '{
"model": "glm-5.3-flashx",
"messages": [{"role": "user", "content": "你好"}],
"max_tokens": 512,
"stream": true
}'
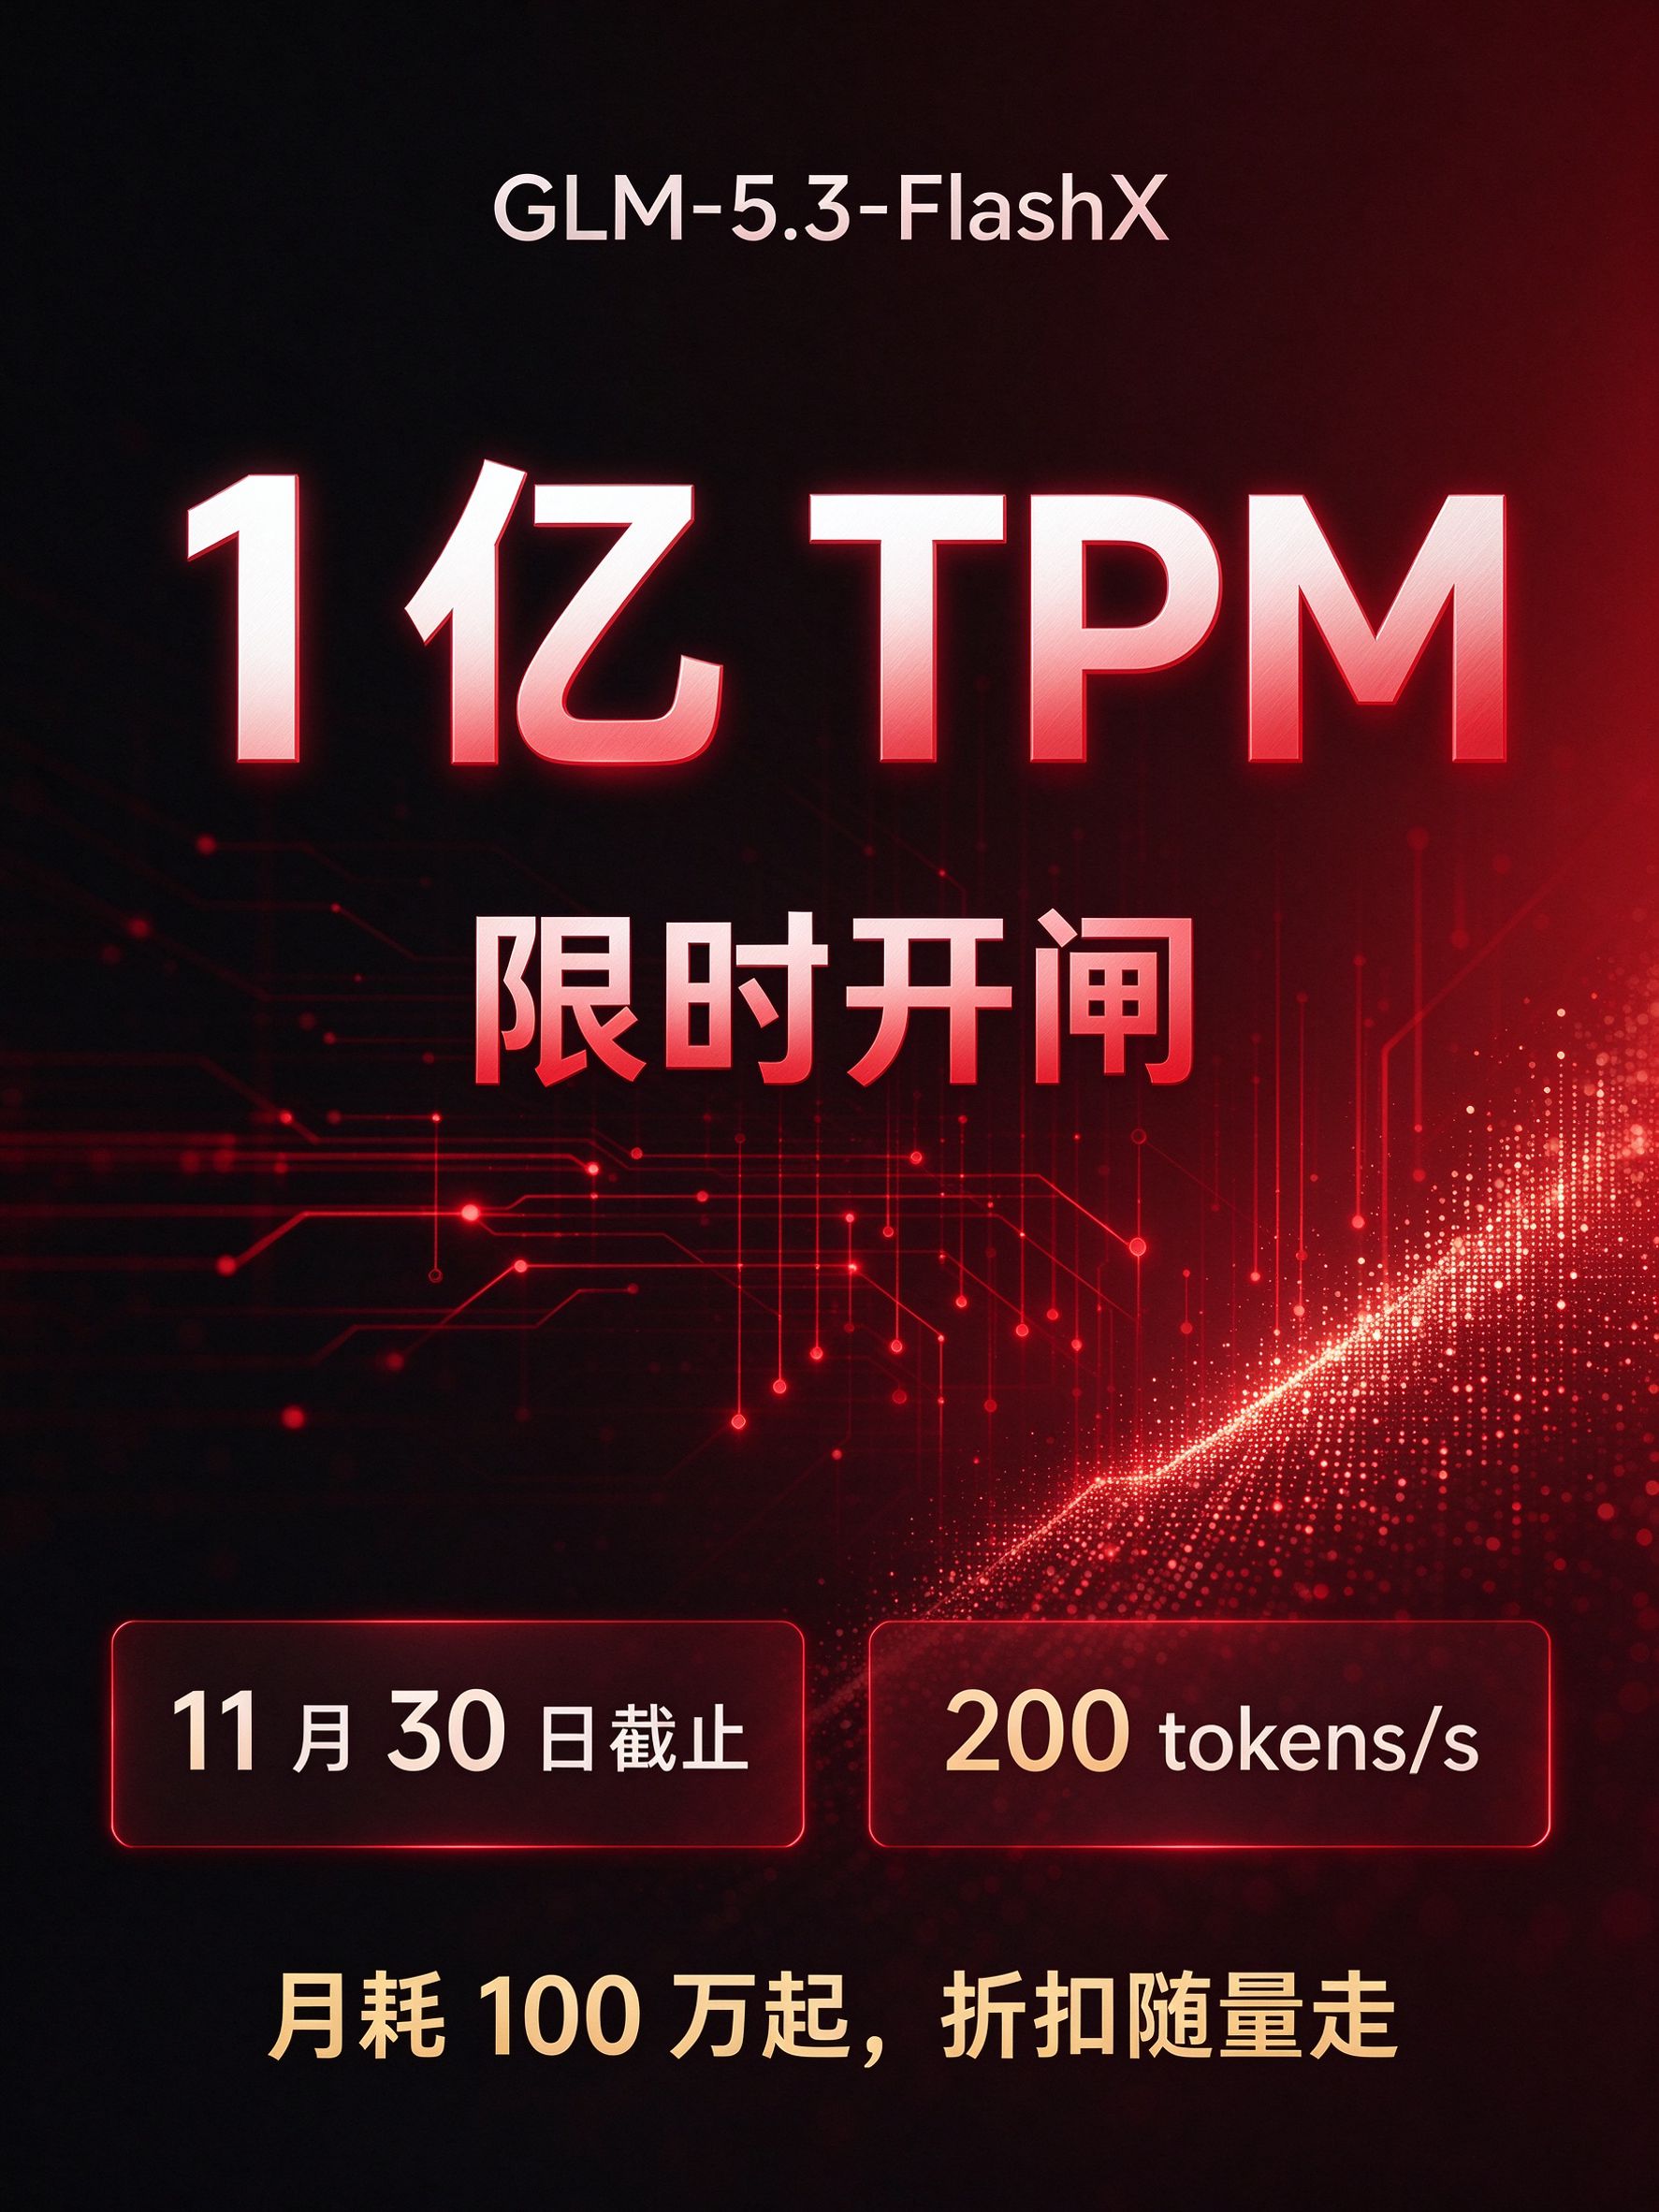
1 亿 TPM 并发额度,限时开放
原生多模态 · 1M 上下文 · 200+ tok/s | 单账号月消耗 100 万起,专属折扣随量谈
API 端点:https://api.thhtcloud.com
立即接入 · 申请折扣已复制到剪贴板